SquirrelSentry by Reluvate
エージェンティック・ガバナンスで、行方不明のお客様とインシデントを見つけます
すべてのモデルは、貴社の監視室に届く前に当社のAIエージェントが攻撃・修正・評価し、変更ごとに貴社のチームが承認します。お客様の安全のために設計しており、顔は使わず、すべての対応は人が判断します。
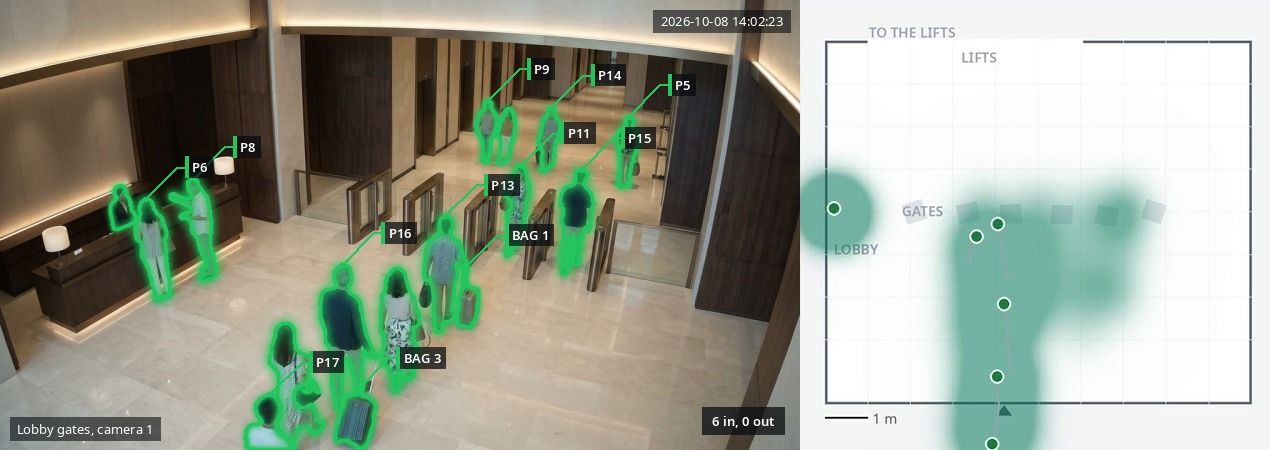
本サイトの画像はすべて生成画像です。
すべてのモデルは、貴社の監視室に届く前に当社のAIエージェントが攻撃・修正・評価し、変更ごとに貴社のチームが承認します。お客様の安全のために設計しており、顔は使わず、すべての対応は人が判断します。
本サイトの画像はすべて生成画像です。
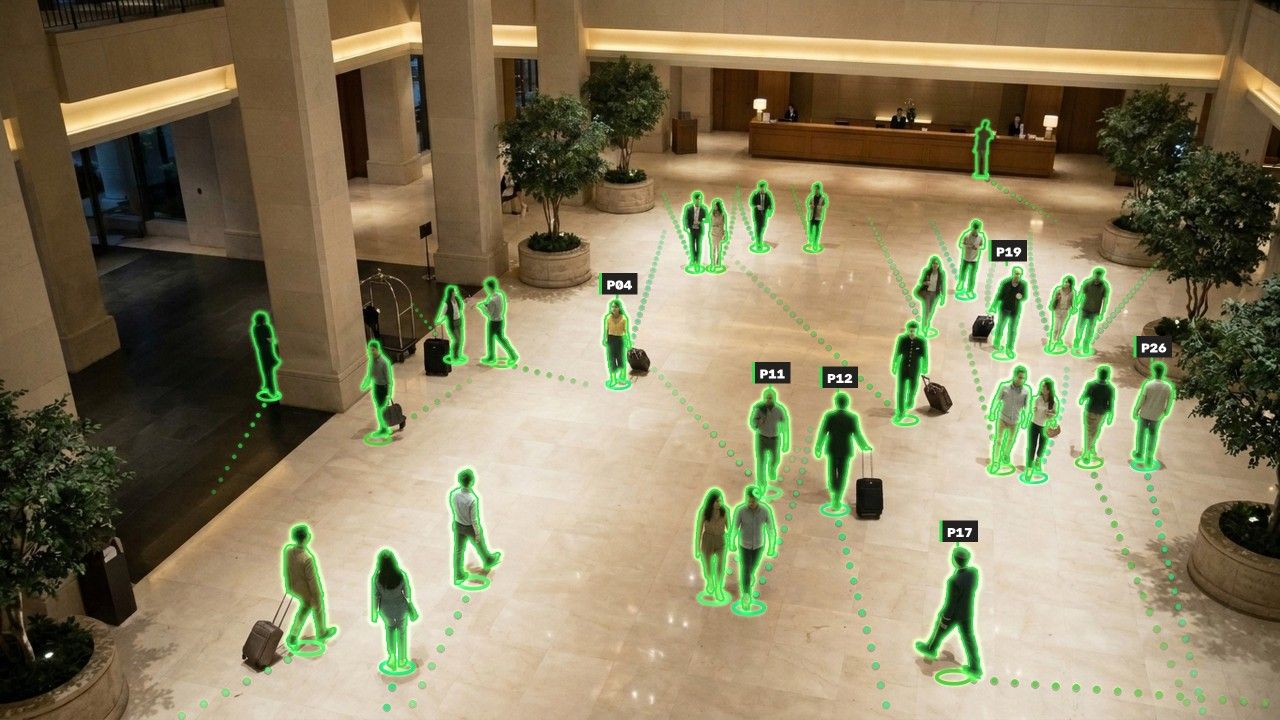
貴社のフロア図面から作成した3Dモデル上にカメラを配置し、人物の最終確認位置までをたどります。
人物や行動を言葉で説明すると、それが映ったすべてのカメラを時刻順に表示します。
場所ごとに30分単位で平常状態を学習し、すべてのアラートで何が違うのかを文章で示します。
暴力行為、転倒、走行を、フレームごとの身体の動きから読み取ります。
武器、置き去り荷物、現場の物品、家具を、当社のチームが学習させています。
エージェントチームが複数のモデル群をテスト・評価・統制し、検出の種類ごとに赤・黄・緑のしきい値を設定します。
同行者から行方不明の連絡が入ります。現状では、多数のカメラの録画を何分もかけて再生する場合があります。
人物を言葉で説明すると、すべての検出記録が時刻順に表示され、最終確認位置まで示されます。
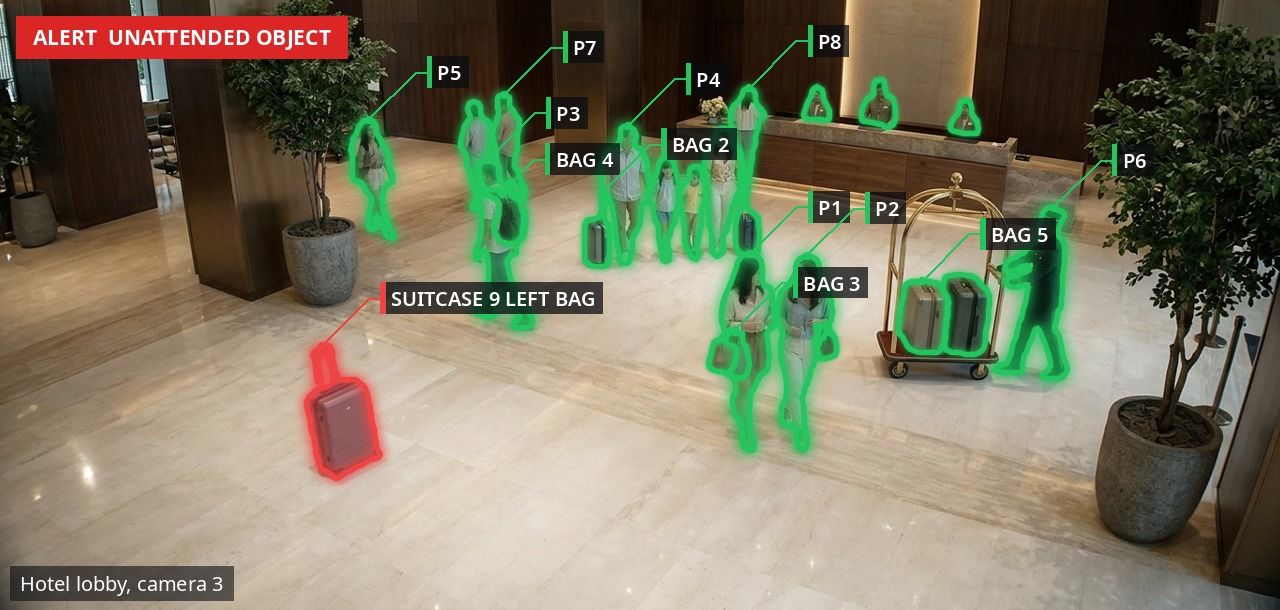
エレベーターホールの脇に荷物が置かれています。数百の映像の中では、オペレーターが気づかない可能性があります。
置いた人物のクリップ付きでアラートを出します。次の対応は人が判断します。
荷捌き場や通路は人が少ないため、普段と違う動きを見逃しやすくなります。
エリアごとに30分単位で平常状態を学習し、アラートで何が違うのかを文章で示します。
当社の想定であり、貴社の数値ではありません。実際のタスクと指標は、検証前に貴社チームが設定します。
各モデルは個別の判定に基づいて採用
モデルの変更はすべて、テスト、評価、貴社が指名した責任者の承認、記録を経て行われ、元に戻すことができます。
汎用モデルの上に当社独自の検出クラスを追加しているため、武器、台車、置き去り荷物を主要な対象として扱えます。
すべてのモデルは、アラートを1件でも出す前に、学習に使っていない画像で事象ごとに評価します。
実際の映像にはめったに映らない暴力行為、転倒、置き去り荷物を再現するため、施設全体を合成環境として構築します。
検出モデル、姿勢推定、追跡、人物再識別、視覚言語モデルが連携し、疑わしい検出は別のモデルの判定が一致した場合にのみ採用します。
エージェントが毎回新しいモデルを再学習・テスト・評価し、オペレーターの回答は新しい学習例になります。
顔の照合は行いません。映像、検出記録、すべてのモデルは貴社が管理するサーバー内にとどまります。
| 検出タイプごとの実測しきい値 | 赤のしきい値以上 | 適合率 | 赤または黄で検出 |
|---|---|---|---|
| スーツケース | 0.75 | 1.00 | 91% |
| 大型リュックサック | 0.75 | 1.00 | 96% |
| 行列用ポール | 0.85 | 1.00 | 100% |
| タワーコンテナ | 0.85 | 1.00 | 100% |
| マチェーテ | 0.70 | 1.00 | 97% |
| 日本刀 | 0.65 | 0.90 | 87% |
しきい値と適合率は、同じ学習に使っていない評価用画像(2025年8月)から算出しているため、赤のしきい値はすべて貴社の映像で再確認します。調整済みクラスの一部を掲載しています。行列用ポールなどの施設内の物体は、貴社のチームが選んだ場合にのみアラートを出します。
日常的な物体をすでに認識できるモデルが、それを忘れずに当社のセキュリティ用クラスを学習します。
25回の学習は毎回、保持中のモデルから始め、スコアが上回った場合にのみ置き換えます。
赤と黄のしきい値はクラスごとに設定するため、アラートの種類ごとに個別のスコア曲線で調整されます。
黄の検出は人に届く前に視覚言語モデル(VLM)で確認し、適合率をさらに高めます。
出典:当社の検出モデルの学習記録と検出クラス別しきい値ファイル(2025年7月〜9月、学習に使っていない評価用画像で測定)。mAP50、検出率、適合率はそれぞれ異なる指標です。
当社の検出モデルの学習設定からの例です。
| 機能 | 動体検知型の映像解析 | レルベイトとSquirrelSentry |
|---|---|---|
| 平常状態の学習 | カメラごと、動きから判定 | 場所と時間帯ごと、人と物から判定 |
| 映っている人物・物体の認識 | 動きのみ | 113の物体クラス、人物とその所持品 |
| カメラ間の同一人物照合 | カメラごとに個別 | 服装と体格で照合。照合率は貴社での検証で評価 |
| 理由を文章で提示 | ここで何か異常が発生 | 何が、どこで、誰が、平常とどう違うか |
| 自然文検索 | 動体検知型の映像解析には含まれない | 外見の説明、行動、場所 |
| 新たなニーズに合わせた学習 | 動きに限定 | 貴社の映像で学習し、アラート前に測定 |
| 確認可能な精度 | 導入事例全体での記載値 | 貴社自身の映像でのイベント別F1 |
左列は動体検知型の映像解析です。現在は多くの映像プラットフォームが、独自に外見検索やテキスト検索を追加しています。
イメージ用のモデルです。現地では貴社のフロア図面から構築します。
1,686件の検出記録を66 msで検索し、同じ特徴の人物を2台のカメラで時刻順に検出
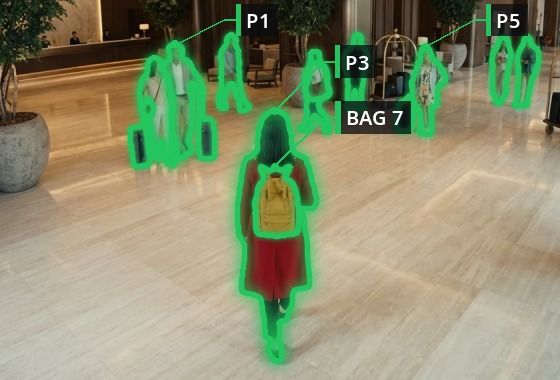
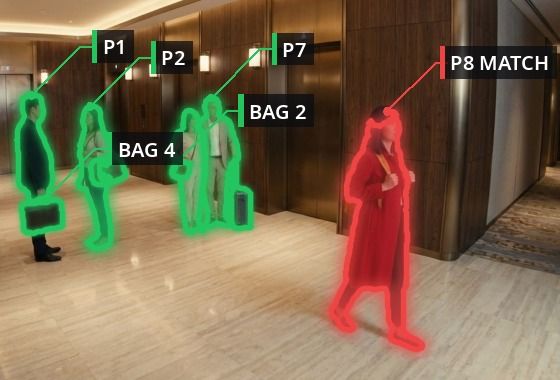
12階エレベーターホール、カメラ1。その39秒前にロビー入口で確認。すべての検出記録からクリップを開けます。
行動も同じ記録に含まれるため、「暴力行為はあるか」や「床に横たわっている人」で検索すると、カメラ、時刻、クリップが返ります。
イメージです。平常範囲は、エリア・時間帯・曜日ごとに貴社の映像から学習します。
113の検出クラス、うち33は当社が学習
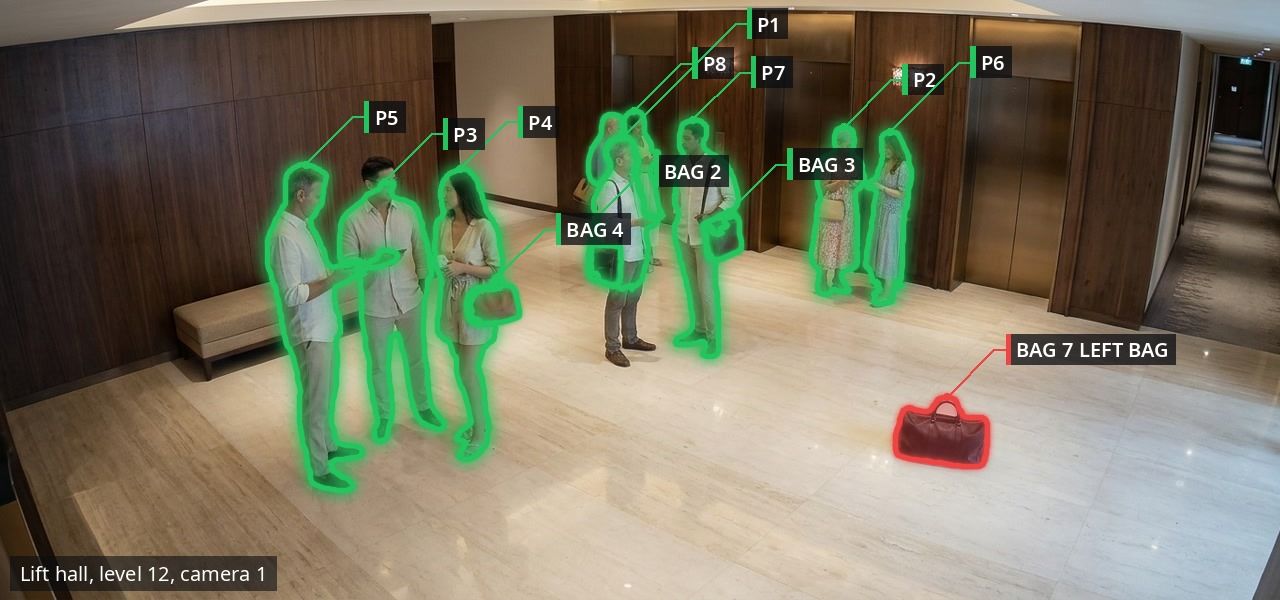
公共交通事業者でF1 1.00
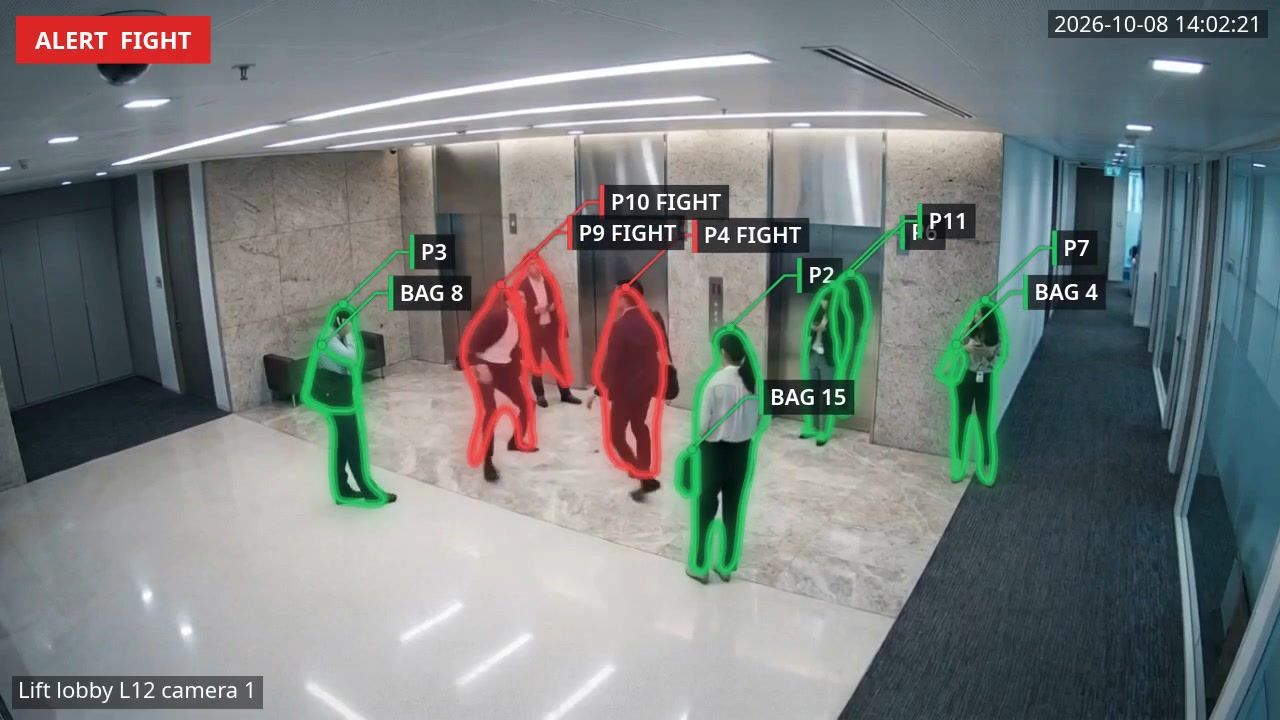
当社の暴力行為テスト映像でF1 0.96
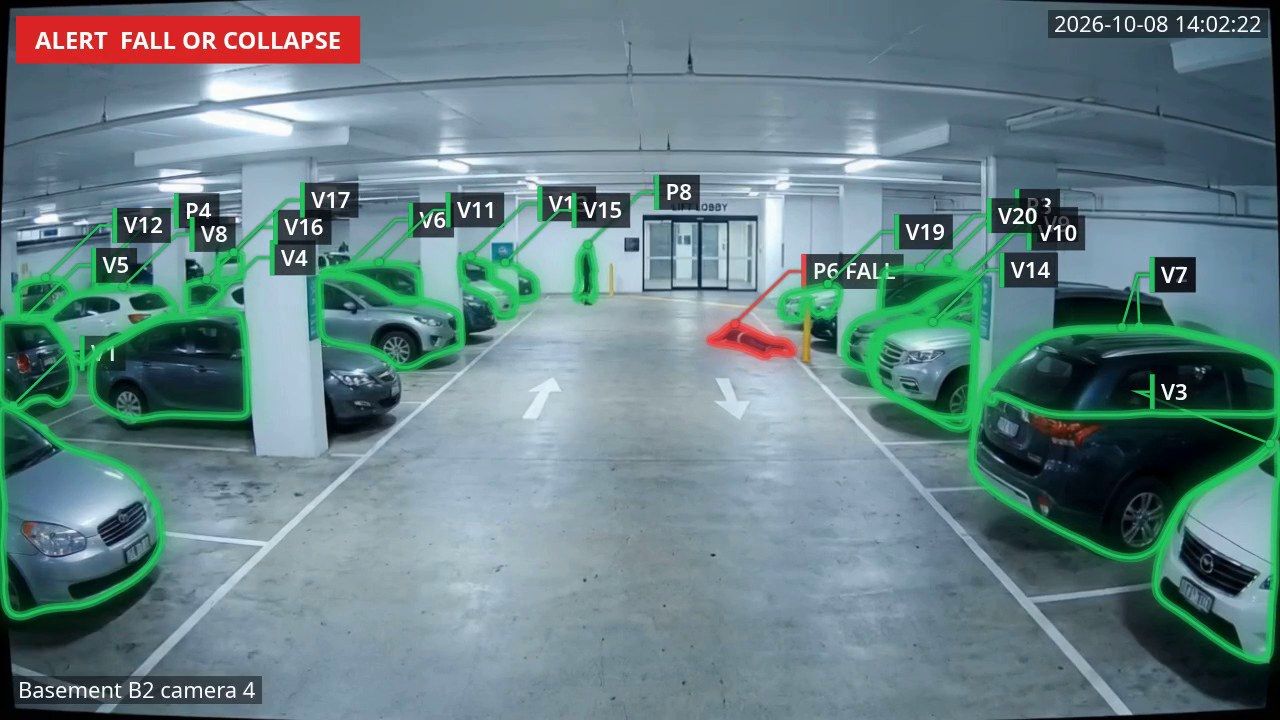
カメラに映る範囲で、映像クリップ付きでアラート
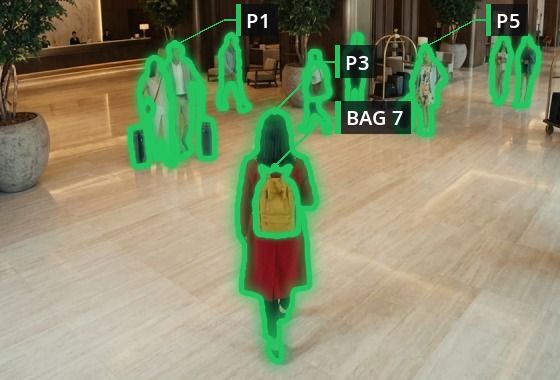
服装と体格で照合(顔は使用しない)
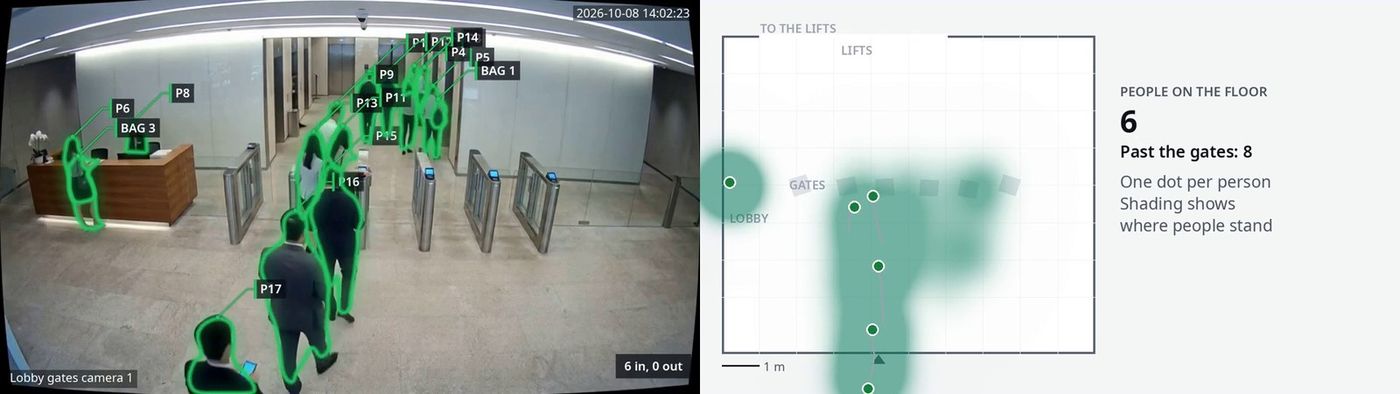
フロア図面上に人物をメートル単位で配置
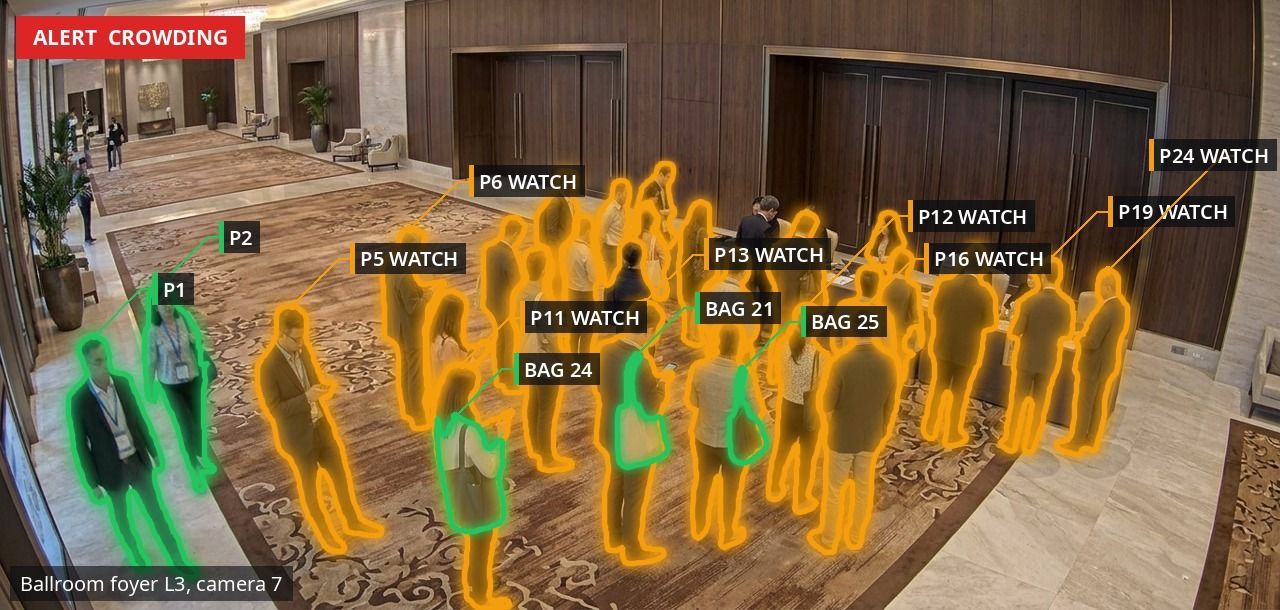
設定した上限に対しゾーンごとに人数を計測
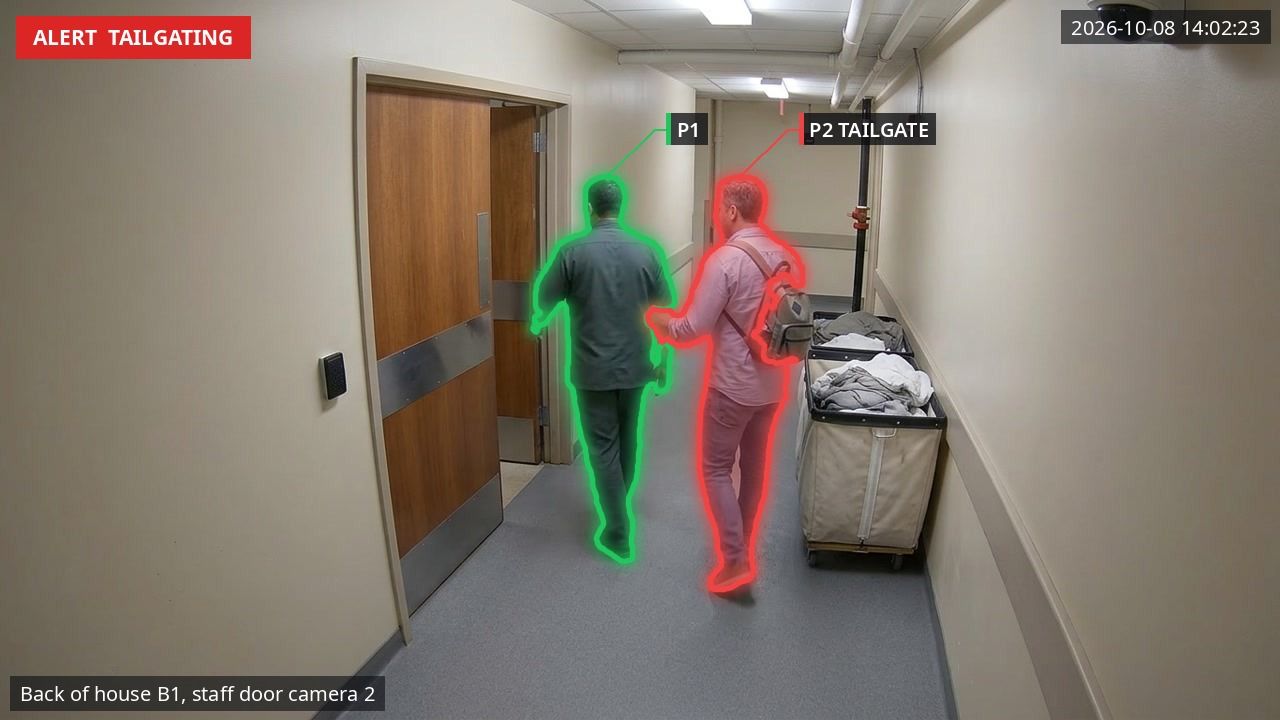
1つの入口を2人が通過
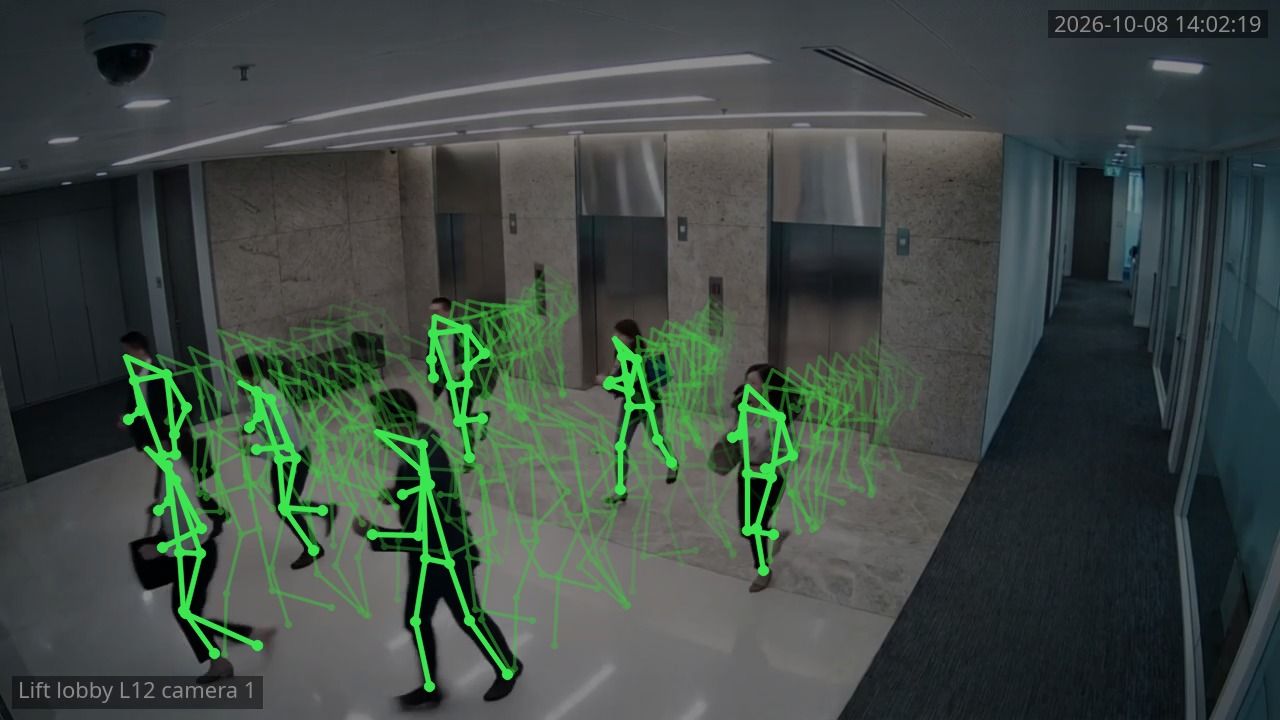
身体の姿勢から速度と方向を判定
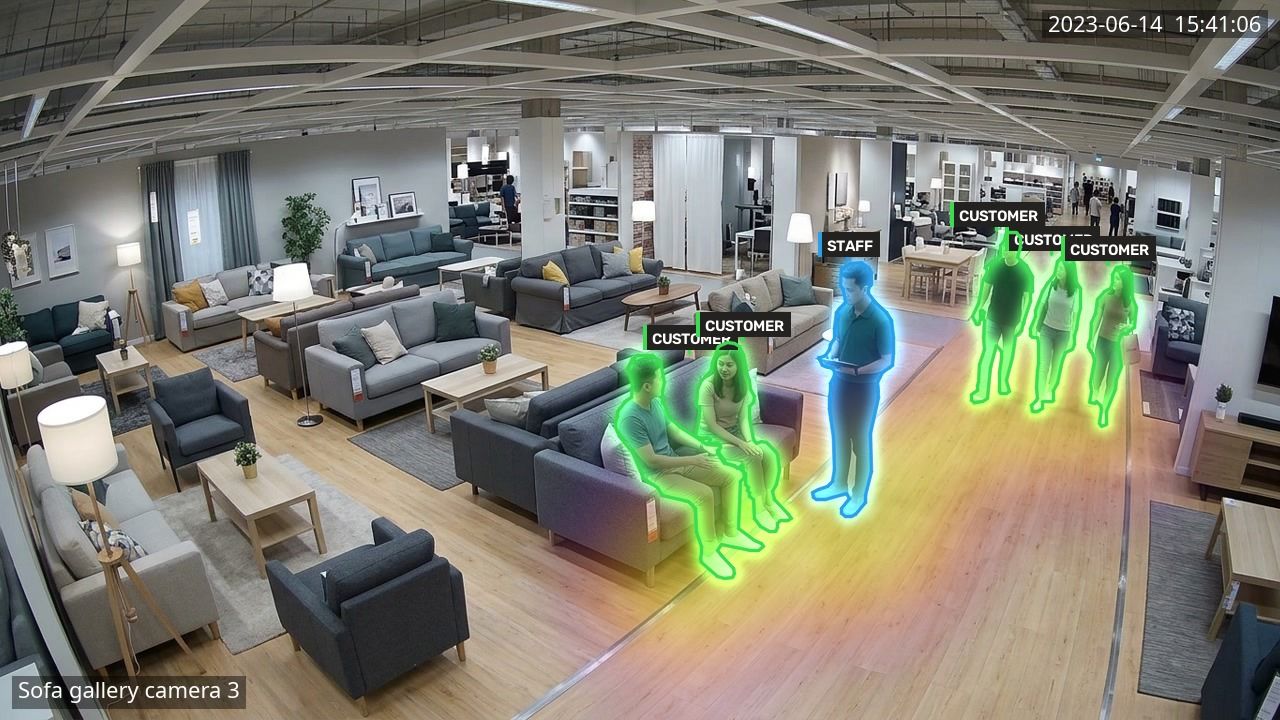
従業員と来訪者を識別し、立ち位置も把握
結果は各プロジェクトのテストセットで測定しています。画像はすべて生成映像によるものです。顧客名は業種で記載しています。
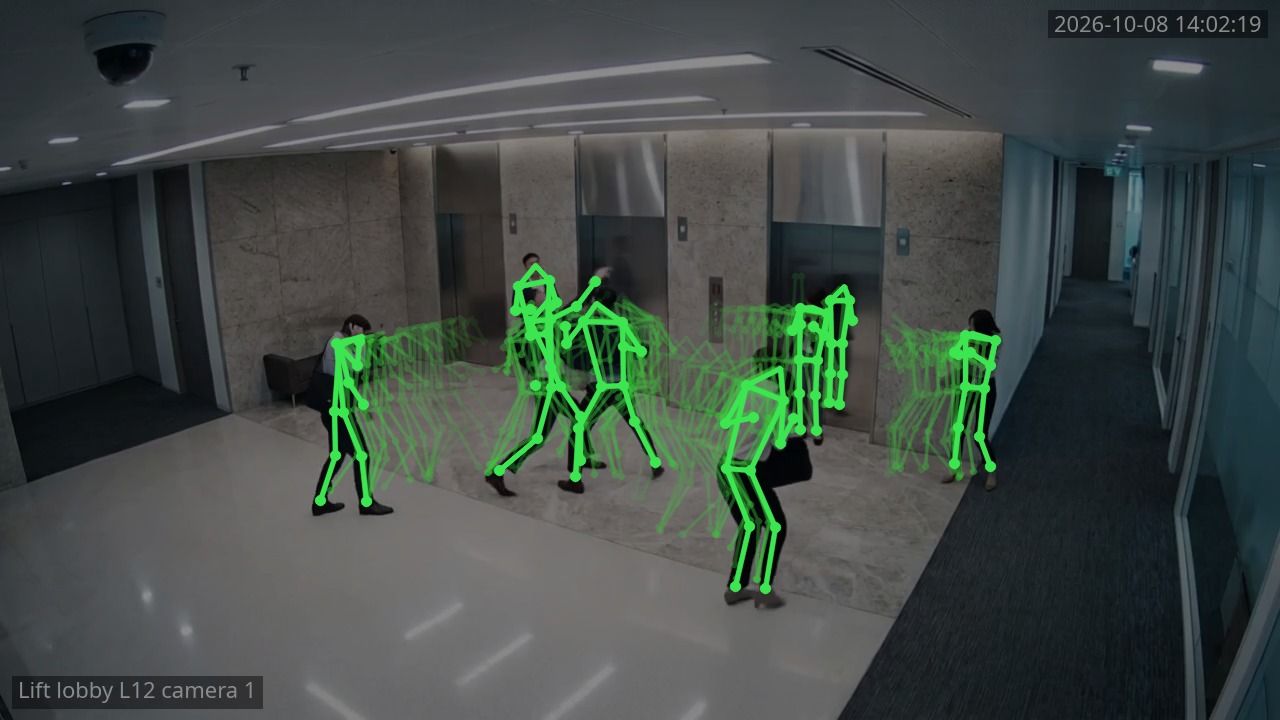
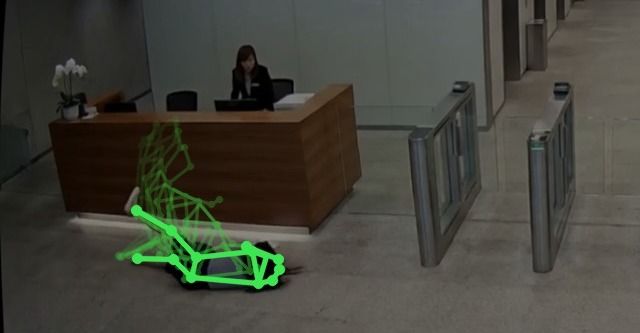
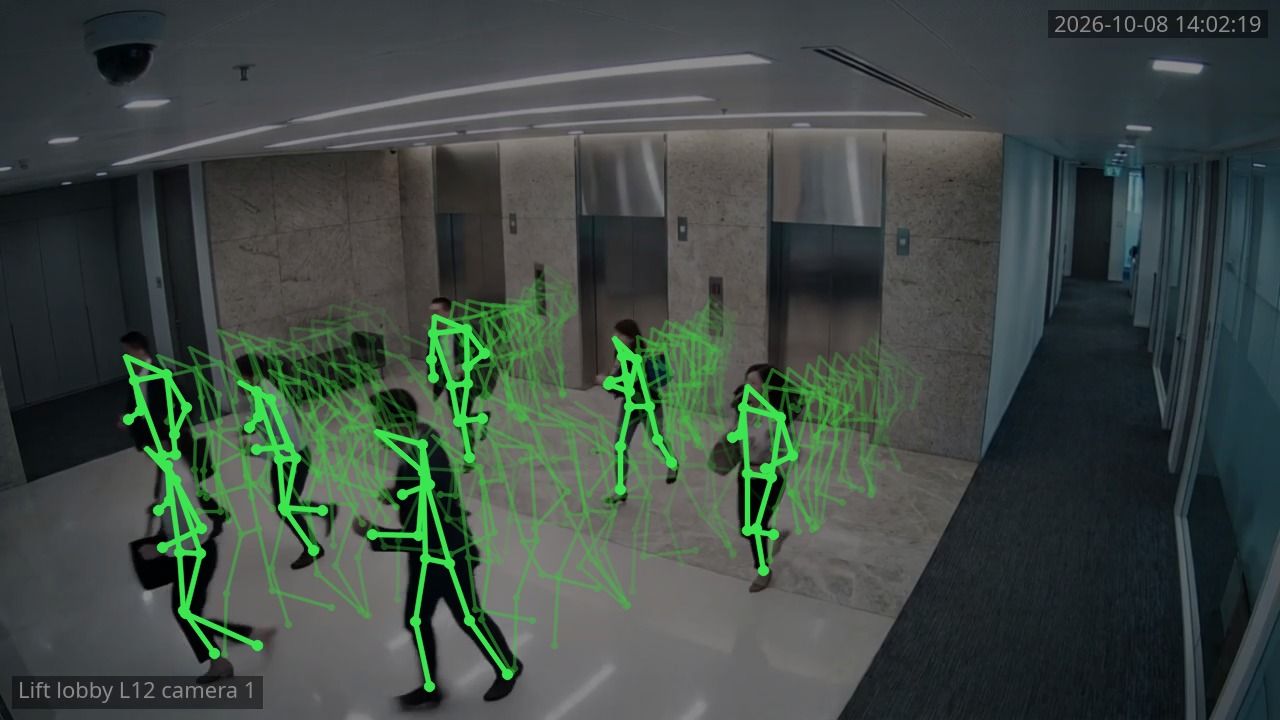
1つの画角内で各人物をフレームごとに追跡
服装・体格・色で照合(顔は不要)
最後の検出からの経過時間で重み付け
検出記録をメートル単位で配置し、フロアをまたぐ経路を再現
公共交通事業者でのF1、駅映像105,057フレーム、2025年
未実証: ホテル、商業施設、コンベンションホール
実在するビルのロビー映像160分間で、すべての荷物を検出
未実証: ピーク時の混雑したホール
行列用ポール、スーツケース、槍を、学習に使っていない評価用画像で測定
未実証: 貴社のカメラ、画角、照明条件
| F1 | 適合率 | 再現率 | |
|---|---|---|---|
| 駅構内の検知事象(顧客の映像) | |||
| 放置物 | 1.00 | 1.00 | 1.00 |
| 改札ゲートの乗り越え | 1.00 | 1.00 | 1.00 |
| 大型物品 | 0.82 | 0.70 | 1.00 |
| 武器 | 0.80 | 0.67 | 1.00 |
| 当社独自の検出クラス(学習に使っていない評価用画像) | |||
| 行列用ポール | 0.93 | 1.00 | 0.87 |
| スーツケース | 0.90 | 0.92 | 0.88 |
| 槍 | 0.86 | 0.80 | 0.94 |
F1 1.00は誤報も見逃しもない状態を意味します。公共交通の数値は検出クラスごとのしきい値設定前に評価したもので、武器アラートの3件に1件は誤報でした。武器のしきい値は現在、学習に使っていない評価用画像から設定し、貴社の映像で再確認します。
駅のカメラで置き去り物と改札ゲートの乗り越えをF1 1.00で、武器と大型物品を0.80〜0.82で検出しています
7台のカメラからの超高解像度フレームを、限られたGPU予算で処理。武器に似たポスター、等身大パネル、行列用ポール。混雑したコンコースでの、テニスボール大の小さな置き去り物。
ショールームのカメラで来店客の動線、立ち止まり、商品への関心を把握し、売場づくりを測定した行動に基づいて判断できるようにしています
ソファ、鏡、陳列が並ぶショールームを映す広角カメラ。従業員と来店客の識別。どの陳列が人を引きつけ、どの陳列が素通りされるかの把握。
画像は生成映像から作成したものです。顧客のカメラ映像は掲載していません。
すべて貴社施設内で完結
映像は現地、検索は貴社のクラウド
貴社のアカウント内のGPUサーバー
オンプレミスでは、すべての構成要素が貴社施設内で稼働し、インターネット接続なしで動作します
ハイブリッド方式では、映像は現地に残し、検出記録とサムネイルのみを貴社のクラウドに送ります
プライベートクラウドでは、GPUサーバーが貴社のアカウント内で稼働し、インターネットに公開される部分はありません
どのカメラでどの検出を行うか
アラートを監視室に届けるまでの許容時間
ユースケースごとに必要な毎秒フレーム数
置き去り荷物は暴力行為より解析の処理負荷が小さい
現在カメラで稼働しているすべてのユースケースと、そのフレームレートおよびGPU負荷。
応答時間に必要な水準より高いフレームレート、または多くのGPUで稼働しているユースケース。
現在のユースケースそれぞれに必要な構成を、変更を加える前に示します。
調査は現在の構成を読み取るだけで、何も変更しません。提案を実行するかどうかは、当社の関与の有無にかかわらず貴社が判断します。
ユースケース、応答時間、カメラが確定するまで、GPU台数は提示しません。
監視室、スマートフォン、外部へのアラート送信
検出、姿勢推定、追跡、照合
貴社が管理するサーバーで稼働
貴社の書面による承認がある場合のみ。映像、画像、検出記録は一切送りません
サービス、キュー、検出記録
オンプレミスまたは貴社のクラウド。レンタルGPUは当社の合成データによる学習にのみ使用
データ保護責任者を指名しています。保存期間と利用目的は貴社のデータ保護責任者と共に設定します。
インシデント対応から越境移転時の保護措置まで、8つのポリシーを整備しています。
読み取り専用のストリームを使用します。映像、画像、検出記録が外部ホスティングのモデルやレンタルGPUに送られることは一切ありません。
照合は服装と体格で行い、顔では行いません。顔はぼかし処理ができます。
録画と検出記録は、貴社が定めるスケジュールで削除します。
本番環境へのアクセスは承認された指名担当者に限定し、すべての操作を記録します。
アラートはオペレーターに送られ、オペレーターを介さずに対応が実行されることはありません。
新しい検出モデルは、評価で現行モデルを上回るまで、現行モデルと並行して稼働します。
55以上の業種領域で導入、65のAI技術を自社開発
シンガポール本社、クアラルンプール、大阪
ご要望に応じて対応。当社がシステムのサポートを終了した場合に限り貴社に開示
契約終了時に貴社の映像と検出記録を削除し、署名付きの記録を提出
| 指標 | 評価方法 | 当社のこれまでの数値 | 貴社の合格基準 |
|---|---|---|---|
| 発見した置き去り荷物 | 置き去り荷物が映っている映像を使用するか、検証用に荷物を設置。検出した荷物を正解として記録した荷物と照合 | ビルのロビー映像160分間で、すべての荷物を検出、誤報ゼロ | 貴社のチームが設定 |
| カメラ1台・1時間あたりの誤報 | オペレーターが誤りと判定したアラート数を、カメラ台数と時間で割った値 | 本検証で初めて測定 | 貴社のチームが設定 |
| 特徴を伝えた人物の発見までの時間(分) | 自然文での説明から最終確認位置のカメラ特定までの時間を、現在の録画再生による確認と比較 | 本検証で初めて測定。検索処理自体は、当社の生成映像で66 msでした | 貴社のチームが設定 |
| カメラ間の照合率 | 貴社チームがラベル付けした人物について、カメラ間で正しく結び付けた検出記録と、誤った結び付け | 本検証で初めて測定 | 貴社のチームが設定 |
| 対応が必要なバックヤードのアラート | オペレーターが対応が必要と判定したアラート。平常範囲の学習には数週間分の映像が必要なため、第1フェーズで開始 | 本検証で初めて測定 | 貴社のチームが設定 |
現時点の当社の数値は、他の施設、学習に使っていない評価用画像、生成映像によるものです。判断の基準になるのは、貴社の映像と貴社の合格基準だけです。
対象カメラと録画・ライブの別を決め、検証計画の各指標について合格基準を設定します。
秘密保持契約(NDA)とデータ取扱契約の締結後、貴社チームが選んだエリアについて、録画映像をお送りいただくか、読み取り専用のライブストリーム用にカメラのIPアドレスをご提供いただきます。映像は終了後に削除し、署名付きの記録を提出します。
各指標を貴社の合格基準に照らして評価し、未達の指標も含めてご報告します。
カメラ、ユースケース、スケジュールは検証結果をもとに設定し、判断ポイントは貴社チームと合意し、契約終了時にはデータを削除します。価格は貴社チームのご準備が整った段階でご提示します。
ご相談にも検証にも義務は生じません。